

Product Information
FPGAでAIを動かしてみる(2)~学習済みモデルの組込み~
はじめに
Efinix社ではFPGA上でAIを動かすためTinyMLプラットフォームを提供しています。
前回はクイックスタートを動かすだけでしたが、 今回は学習済みモデルをFPGAに組み込んでAIを動かしてみます。
環境
- Efinity 2023.2.307.2.17
- Efinity RISC-V Embedded Software IDE 2023.2.1.1
- Titanium Ti60 F225開発キット
Hello worldについて
TinyML Hello World(tinyml_hello_worldディレクトリ)は、静的な入力データに対してAI推論を実行することを目的としたものになります。
得られた推論出力がPCベースのゴールデンモデルとの照合や、高速化のための計算負荷の高いレイヤーの特定などに使用できます。
人物検出や画像分類、キーワードスポッティングなど6つのサンプルが用意されています。
これらAIモデルのトレーニングと量子化スクリプトは、Jupyter Notebook で開発されています。
詳細はmodel_zooディレクトリを参考してください。
今回は、「tinyml_imgc」の画像分類を使います。
| サンプル | モデル | 説明 |
|---|---|---|
| tinyml_ypd | Yolo Person Detection | Yoloアーキテクチャを使用して人物検出 |
| tinyml_pdti8 | MobilenetV1 Person Detection | MobilenetV1アーキテクチャを使用して人の存在を検出 |
| tinyml_imgc | ResNet Image Classification | MobilenetV1アーキテクチャを使用して人の存在を検出 |
| tinyml_kws | DS-CNN Keyword Spotting | ResNetアーキテクチャを使用してオブジェクト分類 |
| tinyml_fl | MediaPipe Face Landmark Detection | MediaPipeアーキテクチャを使用して顔のランドマーク検出 |
| tinyml_ad | Deep AutoEncoder Anomaly Detection | Deep AutoEncodeアーキテクチャを使用して機械の動作音異常を検出 |
1. TFLiteへのモデル変換
エッジAIとしてFPGAにモデルを組み込むには、モデルの軽量化が必要になります。
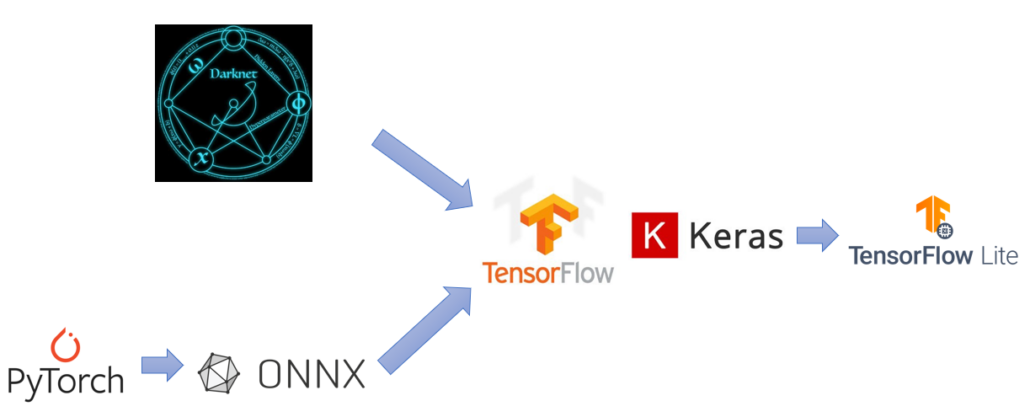
EfinixではTFLite Micro C++ライブラリを提供しており、モデルをTFLite形式に変換することで任意のモデルをFPGA上で動かすことができます。
TinyMLプラットフォームは、PyTorch、DarkNet、TensorFlow、KerasなどのさまざまなフレームワークからTFLiteへのモデル変換方法を提供しています。
詳しくは、モデル変換フロー をご確認ください。
Sapphire SoC
FPGA上に構築するRISC-VベースのCPU。
ユーザー設定可能でニーズに基づいてSoCを構成することができます。
AIアプリはRISC-V(Sapphire SoC)上で動作するTFLite Microライブラリを使用して開発を行います。
TensolFlow Lite Micro
TensorFlowはオープンソースの機械学習プラットフォーム。
TensorFlow LiteはTensorFlowの一部で、エッジデバイス用のモバイルライブラリが提供されています。
TensorFlow Lite Converterは学習後の量子化を容易にして、学習済みモデルを小さなTensorFlow Liteモデルに変換するものです。
TenworFlow Lite MicroはTenworFlow Liteと互換があるように設計されたC++ライブラリです。
Efinix TinyMLアクセラレータ
TFLite Microライブラリと互換性のあるAI用の専用アクセラレータ。
RISC-Vのカスタム命令を介してDMA操作を行い、
AI推論における計算負荷の高いレイヤー/操作を高速化します。
Efinix TinyML Generatorで学習済みモデルに合わせカスタマイズでき、
FPGAリソースを効率的に利用が可能です。
LiteモードとStandardモードの2つのモードをサポートしています。
- Liteモード : リソース消費が少ない軽量アクセラレータ
- Standardモード : より多くのリソースを消費する高性能アクセラレータ
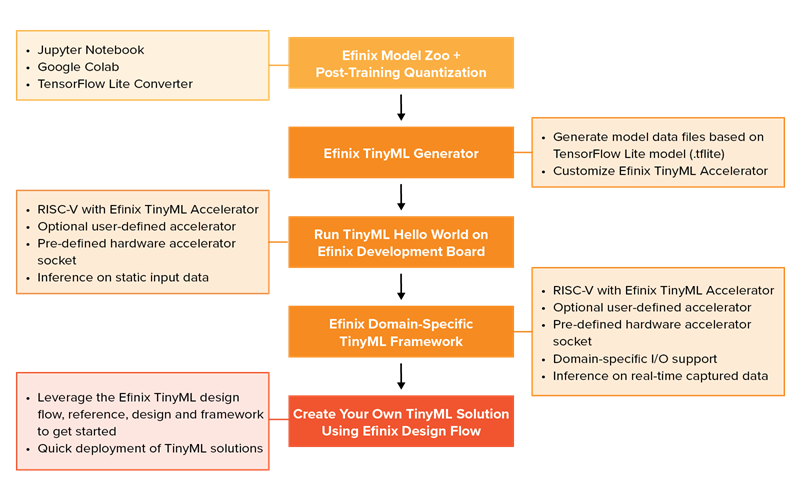
TinyMLを使った開発の流れ
- TensorFlow Liteの学習済みモデルを用意
- “Efinix TinyML Generator”を使い、学習済みモデルからEfinix TinyML Accelratorをカスタマイズ
- 評価ボード上でTinyML Hello Worldを実行して動作確認
- 仕様に合わせたI/Oなどカスタマイズ
- 自分たち向けのTinyMLソリューションを作成
2. アクセラレータのカスタマイズ
TinyMLアクセラレータは、DMA用のAXIインターフェースとRSIC-V用のカスタム命令インタフェースを備えており、AI推論における計算負荷の高いレイヤーや操作を高速化します。
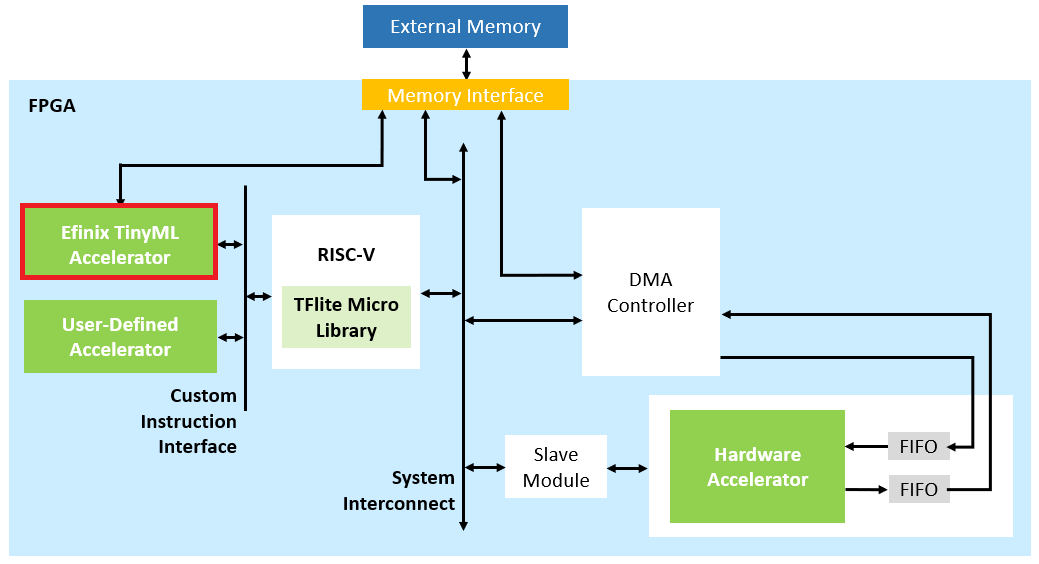
RISC-Vプロセッサは、TFLite Microライブラリで利用するカスタム命令を通じて、アクセラレータでAI推論を実行します。
ただし、TFLiteモデルをそのままFPGAに組み込むことはできないため、カスタマイズが必要です。
このため、Efinix TinyML Generatorを使用して、モデルのCソースと設定ファイルを生成し、アクセラレータのカスタマイズします。
さっそく、TFLiteモデルを使ってアクセラレータのカスタマイズを行ってみましょう。
Efinix TinyML Generatorの起動
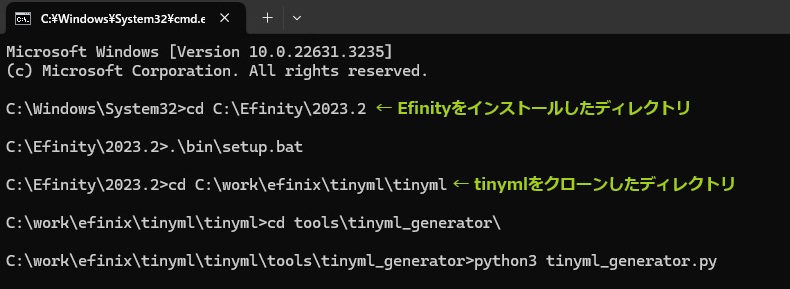
「python3 tinyml_generator.py」を実行して、TinyML Generatorのウィンドウを立ち上げます。 事前に「setup.bat」実行して、Efinityの環境変数をセットしておく必要があります。
カスタマイズおよびモデルデータファイルの生成
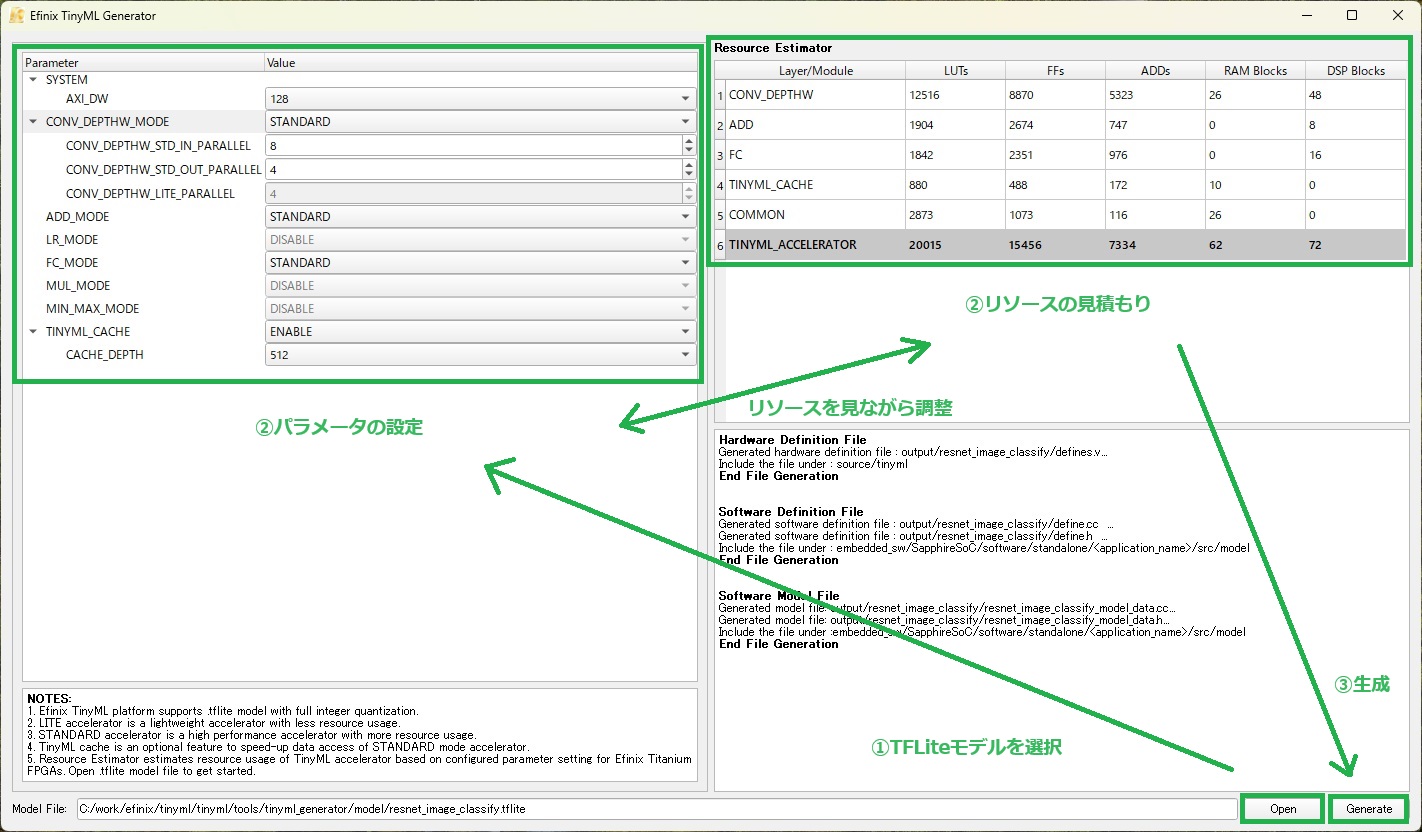
TinyML Generatorにモデルを読み込ませ、リソースを見ながらパラメータを調整します。
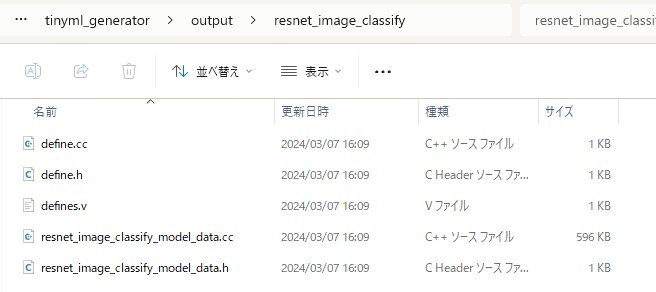
生成を実行すると、モデルファイル、および、ソフトウェアとハードウェアの設定ファイルを出力されました。
今回は用意されていた画像分類モデル(resnet_image_classify.tflite)を使いました。
- Openでtfliteモデルを選択
- Resource Estimatorでリソースを確認しながら、パラメータを調整
AXI_DWはAXIデータバス幅、デフォルトでTi60は128bit、Ti180は512bitに設定 - 設定が完了したらGenerateをクリック
output/<モデル名>にファイルが出力
TinyML Generatorで生成されたファイル
補足:ハードウェアアクセラレータとは
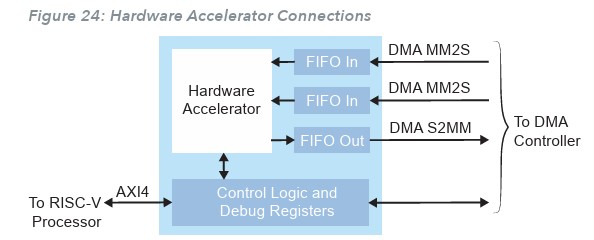
ハードウェアアクセラレータは、構造化された「コンテナ」であり、アクセラレータを素早く簡単に組み込むことができるソケットとなります。
ソフトウェアとハードウェアは統合されており、ハードウェアアクセラレータに用意された標準機能はソフトウェアコードとして利用できます。
RISC-Vプロセッサは「アクセラレータの機能」を組み込みソフトとして実行します。
RTLデザインでは、トップレベルのラッパー(hw_accel_wrapper.v)が、アクセラレータ、入出力のFIFOバッファ、RISC-Vに接続するAXI4モジュール、および、デバッグとコントロールレジスタで構成されています。
FIFOと制御ロジックは外部メモリから入力データをフェッチし、DMAコントローラを通して外部メモリに出力を格納します。
このラッパーは標準インターフェースを提供するように設計されているため、独自のアクセラレータ機能を簡単に追加できます。
このフレームワークにより、設計作業を減らし、迅速かつ簡単に設計することができます。
TinyMLアクセラレータは、AI推論のアクセラレータ、RISC-Vのカスタム命令インタフェース、
DMA用のAXIインタフェース、で構造化されたコンテナであり、RTLデザインのトップレベルラッパーが tinyml_top.v になります。
コンテナとしてデータのやりとりなどは標準インタフェースとして提供するように設計されているため、AI推論のアクセラレータ機能を簡単にカスタマイズできます。
このカスタマイズのためのツールがTinyML Generatorになります。
3. コンパイルとビットストリームの書き込み
プロジェクトの準備
Ti60F225_tinyml_hello_worldをダウンロードして、
先ほどアクセラレータのカスタマイズで生成したモデルファイルに置き換えました。
| ファイル名 | Efinityのプロジェクトの置き換え場所 |
|---|---|
| define.v | /source/tinyml/ |
| define.h define.cc, |
/embedded_sw//software/standalone/<アプリ名>/src/model/ |
| <モデル名>.cc、 <モデル名>.h |
embedded_sw//software/standalone/<アプリ名>/src/model/ |
プロジェクトのコンパイル
Efinityでプロジェクトを開くと、IPのアップデートが聞かれるので「Yes」でアップデートを行います。
アップデートが完了したらコンパイルを行ったのですが、エラーが発生してコンパイルに失敗しました。
IPアップデートでDMAコンフィグが正しく反映されていないのが原因のようです。
“CHANNEL 2 Enable”および “CHANNEL 3 Enable “が”Disable”になっていました。
DMAのIPで「右クリック > Configure」で設定画面を開き、”Enable”に修正してIPの更新を行いました。
※ Efinity2023.1の場合、左側のIPで「右クリック→Generate」ですべてのIPを生成する必要があります
書き込み
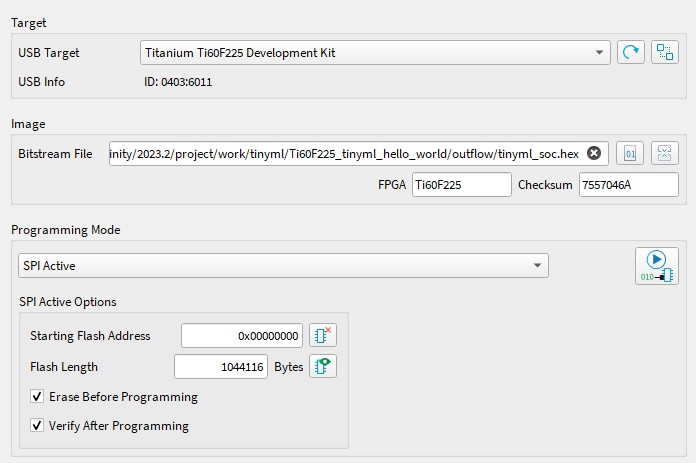
Edge Vision SoC User Guideの「Set Up the Hardware」を参照して評価ボードをセットアップしました。Efinity Programmerを起動して、ビットストリーム(.hex)を選択、”SPI active mode”にして書き込みます。
4. アプリの実行
アプリのセットアップ
「Einity RISC-V Embedded Software IDE」を起動して、プロジェクトをインポートします。
“tinyml\Ti60F225_tinyml_hello_world\embedded_sw\SapphireSoc\software\standalone\tinyml_imgc”
サンプルの手順では、コンパイルで速度最適化のため環境変数を修正の記載があるため、その通りに修正します。
- プロジェクトで右クリック > Preferences > C/C++ > Build -> Environment
BENCH=yes
DEBUG=no
DEBUG_OG=no
アプリの動作
評価ボードの電源を入れシリアル表示の準備を行います。
Einity RISC-V Embedded Software IDE からアプリを実行します。
tinyml_imagec_ti.launch を右クリック -> Run As > 1. tinyml_imagec_ti
30秒程度まつと、シリアルにAIアプリの実行内容が表示されました。
DEPTHW_INPUT_CNT:8; DEPTHW_OUTPUT_CNT:4.
CONV_INPUT_CNT:8; CONV_OUTPUT_CNT:4.
–Hello Efinix TinyML–
TinyML Setup…
Total output layers: 1
Input shape: 4 1 32 32 3, type: 9
Output shape 0: 2 1 10, type: 9
DoneImage Classification Inference 1 (Airplane)…Done
quant_airplane score: 9
quant_car score: -128
quant_bird score: -125
quant_cat score: -128
quant_deer score: -127
quant_dog score: -116
quant_frog score: -127
quant_horse score: -31
quant_ship score: -128
quant_truck score: -124
Inference clock cycle (hex): 0x0, 0x4a1f5b
SYSTEM_CLINT_HZ (hex): 0x5f5e100
NOTE: processing_time (second) = timestamp_clock_cycle/SYSTEM_CLINT_HZ
Inference time: 48ms~~省略~~
アプリの説明
「tinyml_imgc」はResNetアーキテクチャを利用した画像分類で、今回の学習済みモデルは10種類の中から分類します。
ここでは、main.ccのコードについて簡単に説明します。
今回は評価ボードを使って、TinyMLのクイックスタートを動かしました。
次回は学習済みのモデルを使って、Efinix TinyMLアクセラレートをカスタマイズ、開発キット上でHello Worldのサンプルを動かしてみたいと思います。
TfLiteStatus invoke_status;
MicroPrintf(“TinyML Setup…”);
tinyml_init();
MicroPrintf(“Done\n\r”);
tinyml_init()でTFLite Micro C++ライブラリを使い、モデルのロードなど設定を行います。
//Copy test image to tflite model input.
for (unsigned int i = 0; i < quant_airplane_dat_len; ++i) model_input->data.int8[i] = quant_airplane_dat[i];
FPGA上で動かすので入力データとしてファイル入力が使えないため、静的データとして配列にして画像ごとにヘッダファイルを用意しています。
この配列データ(quant_airlane_dat[])を入力をモデルへコピーしています。
//Perform inference
timerCmp0 = clint_getTime(BSP_CLINT);
invoke_status = interpreter->Invoke();
timerCmp1 = clint_getTime(BSP_CLINT);
次にAIの処理になるのですが、その前後に時間測定のコードを入れ、処理にかかる時間を計測しています。
//Retrieve inference output
for (int i = 0; i < kCategoryCount; ++i) MicroPrintf(“%s score: %d\n\r”, kCategoryLabels[i], interpreter->output(0)->data.int8[i]);
AIで処理した結果について、10種類のうちどのくらいの確率かシリアルに表示しています。
timerDiff_0_1 = timerCmp1 – timerCmp0;
v = (u32 *)&timerDiff_0_1;
MicroPrintf(“Inference clock cycle (hex): %x, %x\n\r”, v[1], v[0]);
MicroPrintf(“SYSTEM_CLINT_HZ (hex): %x\n\r”, SYSTEM_CLINT_HZ);
MicroPrintf(“NOTE: processing_time (second) = timestamp_clock_cycle/SYSTEM_CLINT_HZ\n\r”);
ms = timerDiff_0_1/(SYSTEM_CLINT_HZ/1000);
MicroPrintf(“Inference time: %ums\n\r”, ms);
最後に処理の時間を計測して、シリアルに結果を表示になります。
あとは、これをいくつかの画像で繰り返しているのが、サンプルのコードとなります。
最後に
学習済みモデルをFPGAに組み込んで、FPGA上でAIアプリを実行しました。
TinyMLプラットフォームで、モデルを変換、アクセラレータのカスタマイズをサポートしており、FPGAへの組み込むことが簡単にできました。


サンマックス・テクノロジーズ株式会社
〒105-0004
東京都港区新橋4丁目21番3号
新橋東急ビル 5階

電話:03-5733-1720
FAX:03-5733-1740